
JEV AI (TypeSafe) คืออะไร? โมเดลที่ไม่ยอมพูดเป็นข้อความ เชื่อผลลัพธ์ได้แค่ไหน?
17 กันยายน 2569 · AI Analysis · อ่าน 6 นาที
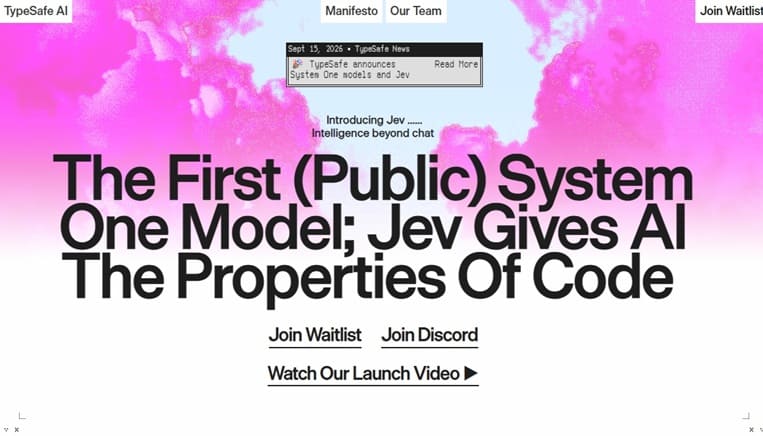
JEV เป็นโมเดล AI จากบริษัท TypeSafe ที่กำลังถูกพูดถึงมากตอนนี้ เพราะมันไม่ตอบเป็นข้อความเหมือน ChatGPT หรือ Claude แต่ตอบกลับมาเป็นตัวเลขความน่าจะเป็น (probability) ทางเลือก (choice) หรือคะแนน (score) แทน จุดที่หลายคนเข้าใจผิดคือคิดว่ามันคือ AI ที่ “ตัดสินใจแทนคน” แต่ในทางเทคนิคแล้ว มันแค่คำนวณความน่าจะเป็นออกมาเป็นตัวเลือก ส่วนใครหรืออะไรจะเป็นคนกดปุ่มตัดสินใจจริงๆ ยังคงเป็นหน้าที่ของโค้ดหรือมนุษย์อยู่ดี
JEV คืออะไรกันแน่
TypeSafe เรียกกลุ่มโมเดลแบบนี้ว่า “System One” ซึ่งเป็นชื่อเรียกของบริษัทเอง ไม่ใช่มาตรฐานอุตสาหกรรม จุดต่างสำคัญจาก LLM ทั่วไปคือ JEV ไม่สร้างข้อความยาวๆ ออกมาอธิบายเหตุผล แต่ส่งคืนค่าที่ถูกจำกัดประเภทไว้แน่นอน 3 แบบ คือ Noul (ความน่าจะเป็นแบบใช่/ไม่ใช่), Choice (เลือกจากตัวเลือกที่กำหนดพร้อมค่าการกระจายความน่าจะเป็น สูงสุด 255 ตัวเลือก) และ Score (คะแนนตามระดับที่เรียงลำดับไว้)
วิธีใช้งานคือส่ง “state” เข้าไป (ข้อมูลตั้งต้น เช่น ตั๋วบริการลูกค้า ประวัติคำสั่งซื้อ นโยบายบริษัท) พร้อมตั้งคำถามหลายข้อพร้อมกันในคำขอเดียว แล้วให้โค้ดของแอปพลิเคชันเป็นคนตัดสินใจต่อว่าจะอนุมัติ ส่งต่อให้มนุษย์ตรวจสอบ หรือเรียกโมเดลที่ใหญ่กว่ามาช่วยเขียนคำตอบ พูดง่ายๆ คือ JEV ทำหน้าที่เป็น “ชั้นตัดสินใจ” ไม่ใช่แอปพลิเคชันสมบูรณ์ในตัวเอง
มันตัดสินใจแทนคนจริงหรือเปล่า
คำตอบคือไม่จริง อย่างน้อยก็ไม่ใช่ในความหมายที่คนส่วนใหญ่เข้าใจ สิ่งที่ JEV ทำคือคำนวณความน่าจะเป็นของแต่ละตัวเลือกออกมาเป็นตัวเลข เช่น ความน่าจะเป็นที่ลูกค้าต้องการขอเงินคืนอยู่ที่ 0.90 หรือความน่าจะเป็นที่เคสนี้ต้องส่งให้มนุษย์ตรวจสอบอยู่ที่ 0.20 ส่วนการตัดสินใจจริงๆ ว่าจะอนุมัติ ปฏิเสธ หรือส่งต่อ ยังคงเป็นเงื่อนไขที่เขียนอยู่ในโค้ดแอปพลิเคชัน ซึ่งทีมพัฒนาเป็นคนกำหนดเกณฑ์เอง
พูดอีกแบบคือ JEV เสนอ “ตัวเลือกพร้อมน้ำหนักความน่าจะเป็น” ให้ระบบหรือมนุษย์นำไปใช้ต่อ ไม่ได้กดปุ่มตัดสินใจเองแบบอัตโนมัติเบ็ดเสร็จ จุดนี้ทำให้ต่างจากภาพที่หลายคนกลัวว่า “AI จะมาตัดสินใจแทนมนุษย์” เพราะโครงสร้างของมันถูกออกแบบให้หยุดอยู่ตรงจุดที่ความไม่แน่นอนเข้ามา แล้วส่งไม้ต่อให้โค้ดหรือคนตัดสินใจแทน
ตัวเลข benchmark บอกอะไรบ้าง
TypeSafe เปิดเผยผลทดสอบภายในของตัวเอง 711 เคส ครอบคลุม 4 งาน (เหตุการณ์ด้านความปลอดภัย, การตรวจสอบ agent trace, การประมวลผลใบแจ้งหนี้, บริการลูกค้า) โดยเทียบกับ “เกณฑ์อ้างอิง” ที่สร้างจากค่าเฉลี่ยการตัดสินของโมเดลอื่นสองตัว (ไม่ใช่ความถูกต้องที่ยืนยันได้จริงจากมนุษย์) ผลรวมทุกงาน JEV ทำได้ประมาณ 67.8% ขณะที่โมเดลเทียบเคียงที่ดีที่สุดทำได้ 74.1% แต่ JEV เร็วกว่าและถูกกว่ามาก โดยเฉพาะงานประมวลผลใบแจ้งหนี้ที่ JEV ตามหลังชัดเจนที่สุด
ข้อจำกัดสำคัญคือ นี่เป็นตัวเลขที่ TypeSafe สร้างและเผยแพร่เอง ยังไม่มีชุดข้อมูลที่มีการติดป้ายกำกับความถูกต้องอิสระจากภายนอกมาตรวจสอบซ้ำ สถานการณ์นี้คล้ายกับที่เคยตั้งข้อสังเกตไว้ในบทความ Grok 4.6 ดีกว่าเดิมยังไง ว่าเบนช์มาร์กที่บริษัทเจ้าของโมเดลรายงานเอง ยังไม่ควรถือเป็นข้อสรุปสุดท้ายจนกว่าจะมีฝ่ายอิสระมาตรวจสอบซ้ำ
“Zero Hallucination” ที่โฆษณาไว้ หมายความว่าอะไรจริงๆ
TypeSafe ใช้คำว่า “zero hallucinations” ในการโปรโมท ซึ่งถูกต้องในความหมายแคบมากๆ คือ JEV ถูกบังคับให้ตอบอยู่ในประเภทข้อมูลที่กำหนดไว้เท่านั้น เช่น ถ้าตั้งตัวเลือกไว้แค่ “บิลลิ่ง, ซัพพอร์ต, เทคนิค” มันจะไม่มีทางตอบเป็นตัวเลือกที่ 4 ที่ไม่มีอยู่จริงออกมา แต่นั่นไม่ได้แปลว่าคำตอบจะถูกต้องเสมอ มันยังสามารถเลือกตัวเลือกที่ “ถูกรูปแบบแต่ผิดความหมาย” ได้อยู่ดี เช่น ตอบว่าเป็นแผนกบิลลิ่งทั้งที่จริงควรเป็นแผนกเทคนิค ซึ่งไม่ใช่ hallucination แบบที่คนทั่วไปเข้าใจ แต่ก็ยังเป็นความผิดพลาดที่ส่งผลจริงในระบบ
แล้วเชื่อได้แค่ไหน
สรุปตรงๆ คือยังเชื่อได้แบบมีเงื่อนไข ตัวเลขความเร็วและต้นทุนที่ต่ำมากดูน่าเชื่อถือเพราะมาจากเอกสารสาธารณะที่ตรวจสอบได้ แต่ตัวเลขความแม่นยำยังมาจากเกณฑ์อ้างอิงที่ TypeSafe สร้างเอง ไม่ใช่ความจริงที่ยืนยันจากภายนอก บริษัทเองก็ยอมรับว่ายังไม่มีการเผยแพร่มาตรวัดการ calibration (ความสอดคล้องระหว่างค่าความน่าจะเป็นกับผลจริง) อย่างเป็นทางการ และ ณ ตอนที่รีวิวต้นทางเขียนบทความนี้ ยังเป็นช่วง early access ที่ไม่มีใครได้ทดสอบผ่าน API จริงเลยด้วยซ้ำ
ใช้ตรงไหนดี ใช้ตรงไหนยังไม่ควร
| งานที่เหมาะ | งานที่ยังไม่ควรใช้ |
|---|---|
| จัดหมวดหมู่/ส่งต่อตั๋วบริการลูกค้าปริมาณมาก | งานที่ต้องการคำอธิบายหรือข้อความยาว |
| จัดอันดับผลการค้นหา (reranking) | งานที่ตัดสินใจผิดแล้วมีต้นทุนสูงและไม่มีชุดข้อมูลตรวจสอบ |
| ด่านตรวจความเสี่ยงก่อนให้ agent ทำงานอัตโนมัติ (มีมนุษย์อนุมัติเป็นค่าเริ่มต้น) | การประมวลผลใบแจ้งหนี้แบบอัตโนมัติเต็มรูปแบบ (benchmark แสดงช่องว่างมากสุด) |
แนวคิดนี้สอดคล้องกับที่เคยเขียนถึงในบทความ คนส่วนใหญ่ใช้ Genspark ทำอะไรกันบ้าง คือเครื่องมือ AI ตัวใหม่แต่ละตัวมักจะเก่งเฉพาะงานบางประเภท ไม่ใช่ตัวแทนที่ใช้แทนกันได้ทั้งหมด การเลือกใช้ให้ตรงจุดสำคัญกว่าการเชื่อคำโฆษณาว่า “เร็วกว่า/ถูกกว่ากี่เท่า” เพียงอย่างเดียว
ทำไมเรื่องความน่าเชื่อถือของ AI ถึงสำคัญขึ้นเรื่อยๆ
กระแสความกังวลเรื่อง “เชื่อผลลัพธ์ AI ได้แค่ไหน” ไม่ได้เกิดขึ้นเฉพาะกับ JEV เท่านั้น ก่อนหน้านี้ก็เคยเขียนถึงกรณี Claude ใส่ลายน้ำในข้อความที่สร้าง ซึ่งเป็นอีกความพยายามหนึ่งในการตรวจสอบที่มาของผลลัพธ์ AI และบทความ ChatGPT ค้นเว็บผ่าน Search Engine ไหนกันแน่ ที่ชี้ให้เห็นว่าเบื้องหลังการทำงานของ AI มักมีรายละเอียดที่ไม่ตรงกับภาพที่คนทั่วไปเข้าใจเสมอไป กรณี JEV ก็เป็นอีกตัวอย่างที่ตอกย้ำว่าคำโฆษณาของบริษัท AI ควรถูกตรวจสอบก่อนเชื่อทุกครั้ง
คำถามที่พบบ่อย
JEV เป็นแชทบอทเหมือน ChatGPT หรือไม่?
ไม่ใช่ มันเป็น API ตัดสินใจที่ตอบกลับเป็นความน่าจะเป็น ตัวเลือก หรือคะแนน ไม่ใช่บทสนทนาแบบข้อความ
JEV ตัดสินใจแทนมนุษย์จริงหรือไม่?
ไม่จริง มันแค่คำนวณความน่าจะเป็นของแต่ละตัวเลือกให้ ส่วนการตัดสินใจว่าจะทำอะไรต่อยังคงอยู่ในโค้ดแอปพลิเคชันหรือขึ้นกับมนุษย์ที่ตั้งเกณฑ์ไว้
“Zero hallucinations” หมายความว่า JEV ตอบถูกเสมอหรือไม่?
ไม่ใช่ หมายถึงคำตอบจะอยู่ในรูปแบบที่กำหนดไว้เสมอเท่านั้น แต่ยังสามารถเลือกตัวเลือกที่ผิดความหมายได้ ซึ่งเป็นคนละเรื่องกับความถูกต้อง
JEV แทนที่ ChatGPT หรือ Claude ได้หรือไม่?
แทนได้เฉพาะงานที่เป็นการจัดหมวดหมู่ จัดอันดับ หรือให้คะแนนปริมาณมาก แต่แทนไม่ได้ในงานที่ต้องเขียนข้อความ อธิบายเหตุผล หรือวางแผนแบบเปิดกว้าง
ตัวเลขความแม่นยำที่ TypeSafe เผยแพร่เชื่อได้แค่ไหน?
เชื่อได้ในระดับหนึ่งแต่ต้องมีเงื่อนไข เพราะเป็นการเทียบกับเกณฑ์อ้างอิงที่สร้างจากโมเดลอื่น ไม่ใช่ความถูกต้องที่ยืนยันจากมนุษย์ภายนอก ควรรอการทดสอบจากบุคคลที่สามเพิ่มเติม
แหล่งอ้างอิง
- Kingy AI — TypeSafe Jev Review
- TypeSafe — Introducing System One Models and Jev
- TypeSafe API Documentation
- Every — hands-on test ของ Jev
Thanacharn J.
20+ ปีในสาย SEO / PPC / Social Marketing โฟกัสงานวิจัยด้าน GEO และ Zero-Click Threat